
14. September 2026
Die Vision hinter der Knowledge Plattform
„Die Zukunft gehört nicht den Unternehmen mit den besten Tools, sondern denen, deren Wissen für Menschen und Maschinen gleichermaßen zugänglich ist.“ Da ist sich Maximilian Gärber sicher. Als Principal Technical Consultant und Visionär hinter der semantischen Knowledge Plattform PANTOPIX SPHERE beschäftigt er sich schon lange mit einem der größten Probleme nahezu jedes Unternehmens. „Mit seinem bekannten Ausspruch ‚Wenn Siemens wüsste, was Siemens weiß‘ hat Heinrich von Pierer um die Jahrtausendwende herum – also vor einer halben Ewigkeit – das zentrale Problem des modernen Wissensmanagements in Worte gefasst“, so Max Gärber. Und das ist heute immer noch genauso aktuell wie damals: Unternehmen kämpfen mit verteiltem Produktwissen, heterogenen Systemlandschaften und Datensilos. Verschärft wird das Problem dadurch, dass wertvolles Expertenwissen häufig gar nicht in Systemen erfasst ist. Steckt es nur in den Köpfen der Mitarbeitenden in Entwicklung, Vertrieb, Service oder Produktmanagement, kann es mit dem Weggang einzelner Personen vollständig verloren gehen.
„Auch bei PANTOPIX begleitet uns dieses Thema von der ersten Stunde an. Als Integrationspartner wurden wir von unseren Kunden immer wieder an denselben Pain Point geführt: verschiedene Systeme und nicht zusammenpassende Datenstrukturen sollen miteinander verbunden werden. Es gab nicht das eine Kundenprojekt, das die Entwicklung von PANTOPIX SPHERE angestoßen hat, sondern das eine zentrale Problem, das alle Unternehmen hatten“, erzählt Max Gärber. „Unsere Lösung ist eine Plattform für die semantische Integration aller Information rund um den Lebenszyklus eines technischen Produkts. Besonders wichtig war uns, PANTOPIX SPHERE als maximal flexible Plattform zu konzipieren, die diese verschiedenen Informationswelten verbindet und daraus eine gemeinsame semantische Wissensbasis entstehen lässt.“
Technologische Besonderheiten von PANTOPIX SPHERE
Semantik als grundlegendes Architekturprinzip
„Die größte Besonderheit von PANTOPIX SPHERE ist der Einsatz von Semantic AI und das ist für uns in der Entwicklung zugleich die größte Hürde gewesen“, so Max Gärber. Semantic AI bringt zwei Arten von künstlicher Intelligenz zusammen, die sich eigentlich fundamental unterscheiden: Symbolic AI (Graph-Technologie) und Non-Symbolic AI (Large Language Models / LLMs).
Large Language Models erkennen Muster und erzeugen Antworten auf Basis statistischer Wahrscheinlichkeiten. Das macht sie leistungsfähig im Umgang mit Sprache und unstrukturierten Inhalten. Graph-Technologie – also ein Wissensgraph – arbeitet dagegen mit explizit modellierten Entitäten, Fakten, Beziehungen und Regeln. Sie kann nachvollziehbar abbilden, welche Information mit welcher anderen Information verbunden ist, und daraus wieder etwas Neues ableiten. Ein Sprachmodell kann beispielsweise feststellen, dass zwei Formulierungen wahrscheinlich dasselbe meinen. Ein Graph kann eine solche Ähnlichkeit nicht voraussetzen. Die Beziehung muss modelliert, geprüft oder aus definierten Regeln abgeleitet sein.
„Das Zusammenspiel dieser beiden KI-Arten ist extrem wichtig für unsere Knowledge Plattform, um die Richtigkeit von Antworten zu verifizieren“, erklärt Max Gärber. „Technologisch gesehen war es eine enorme Herausforderung, beides zu vereinen. Das funktioniert nur, indem man jede der beiden Technologien immer da einsetzt, wo sie stark ist. Man kann sich das wie einen Staffellauf zwischen einem Delfin und einem Löwen vorstellen. Der Delfin ist im Wasser extrem leistungsfähig, der Löwe an Land. Nur zusammen können sie eine Strecke mit Wasser- und Landpassagen bewältigen, an der jeder für sich allein scheitern würde. Das funktioniert aber nur, wenn genau definiert ist, an welcher Stelle der eine übernimmt und wie die Übergabe funktioniert. Die Herausforderung lag für uns also darin, geeignete Übergabepunkte zu schaffen: Wo nutzen wir die Flexibilität eines LLMs und wo brauchen wir die kontrollierte Logik des Wissensmodells?“
Die Verbindung von semantischer Technologie mit einem LLM – also der sogenannte GraphRAG-Ansatz – ist kein nachträglich ergänztes KI-Feature, sondern folgt der grundlegenden Architektur von PANTOPIX SPHERE. Die Plattform war von Beginn an darauf ausgelegt, eine semantische Ebene über bestehende Informationsquellen zu legen und daraus einen Knowledge Graph aufzubauen. Max Gärber grenzt diese Methode klar ab vom inzwischen oft für Unternehmensdaten verwendeten Retrival-Augmented-Generation-Ansatz: „Weder lassen wir Sprachmodelle isoliert auf Daten los noch stellen wir wie beim klassischer RAG-Ansatz einfach nur relevante Inhalte als zusätzlichen Kontext bereitstellt. Mit GraphRAG geben wir dem LLM Zugriff auf semantisch vernetztes Wissen, d. h. auf Informationen, ihre Bedeutung, ihre Beziehungen zueinander und den unternehmensspezifischen Kontext, in dem sie stehen.“
Flexible Datenintegration
„Ich glaube, unsere größte Erkenntnis aus all den Jahren in der Technischen Kommunikation ist, dass es eine schier unendliche Menge an Möglichkeiten gibt, wie Firmen ihre Daten organisieren und strukturieren“, fasst Max Gärber seine Erfahrung zusammen. „Unsere Aufgabe ist es, bestehende und teilweise starre Systeme miteinander zu verbinden. Um das zu erreichen, muss die Software im Zentrum maximal flexibel sein.“ Und das ist PANTOPIX SPHERE. Die Knowledge Plattform ist breit aufgestellt und kann sehr viele Use Cases von Datenanreicherung, Datenintegration über Data Governance bis zu Content Orchestrierung und Delivery in verschiedenste Kanäle oder nachgelagerte KI-Anwendungen bedienen.
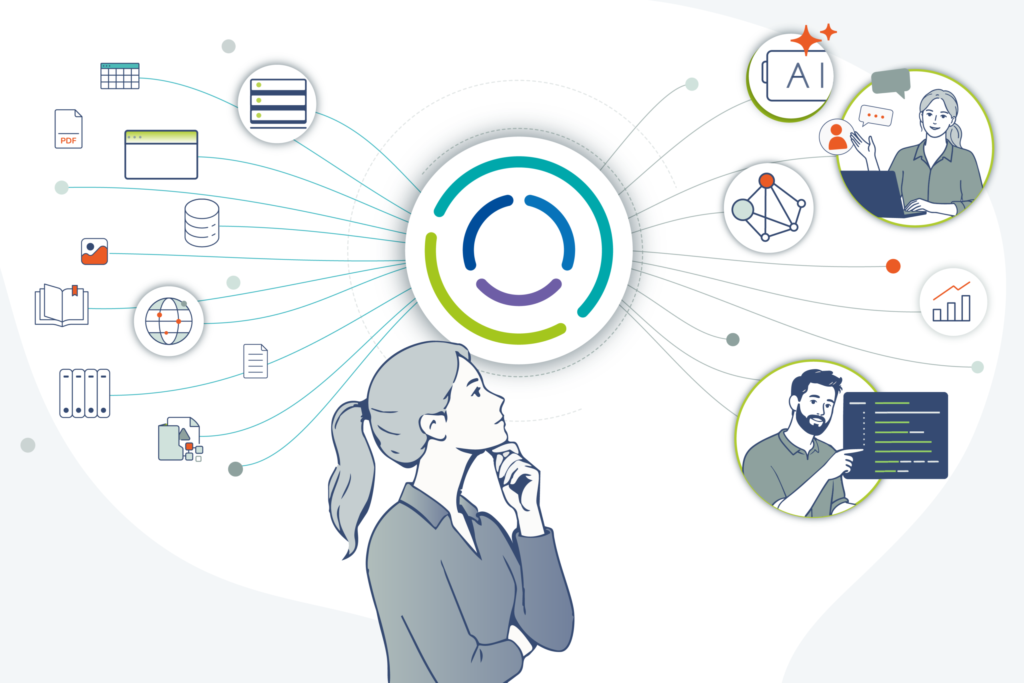
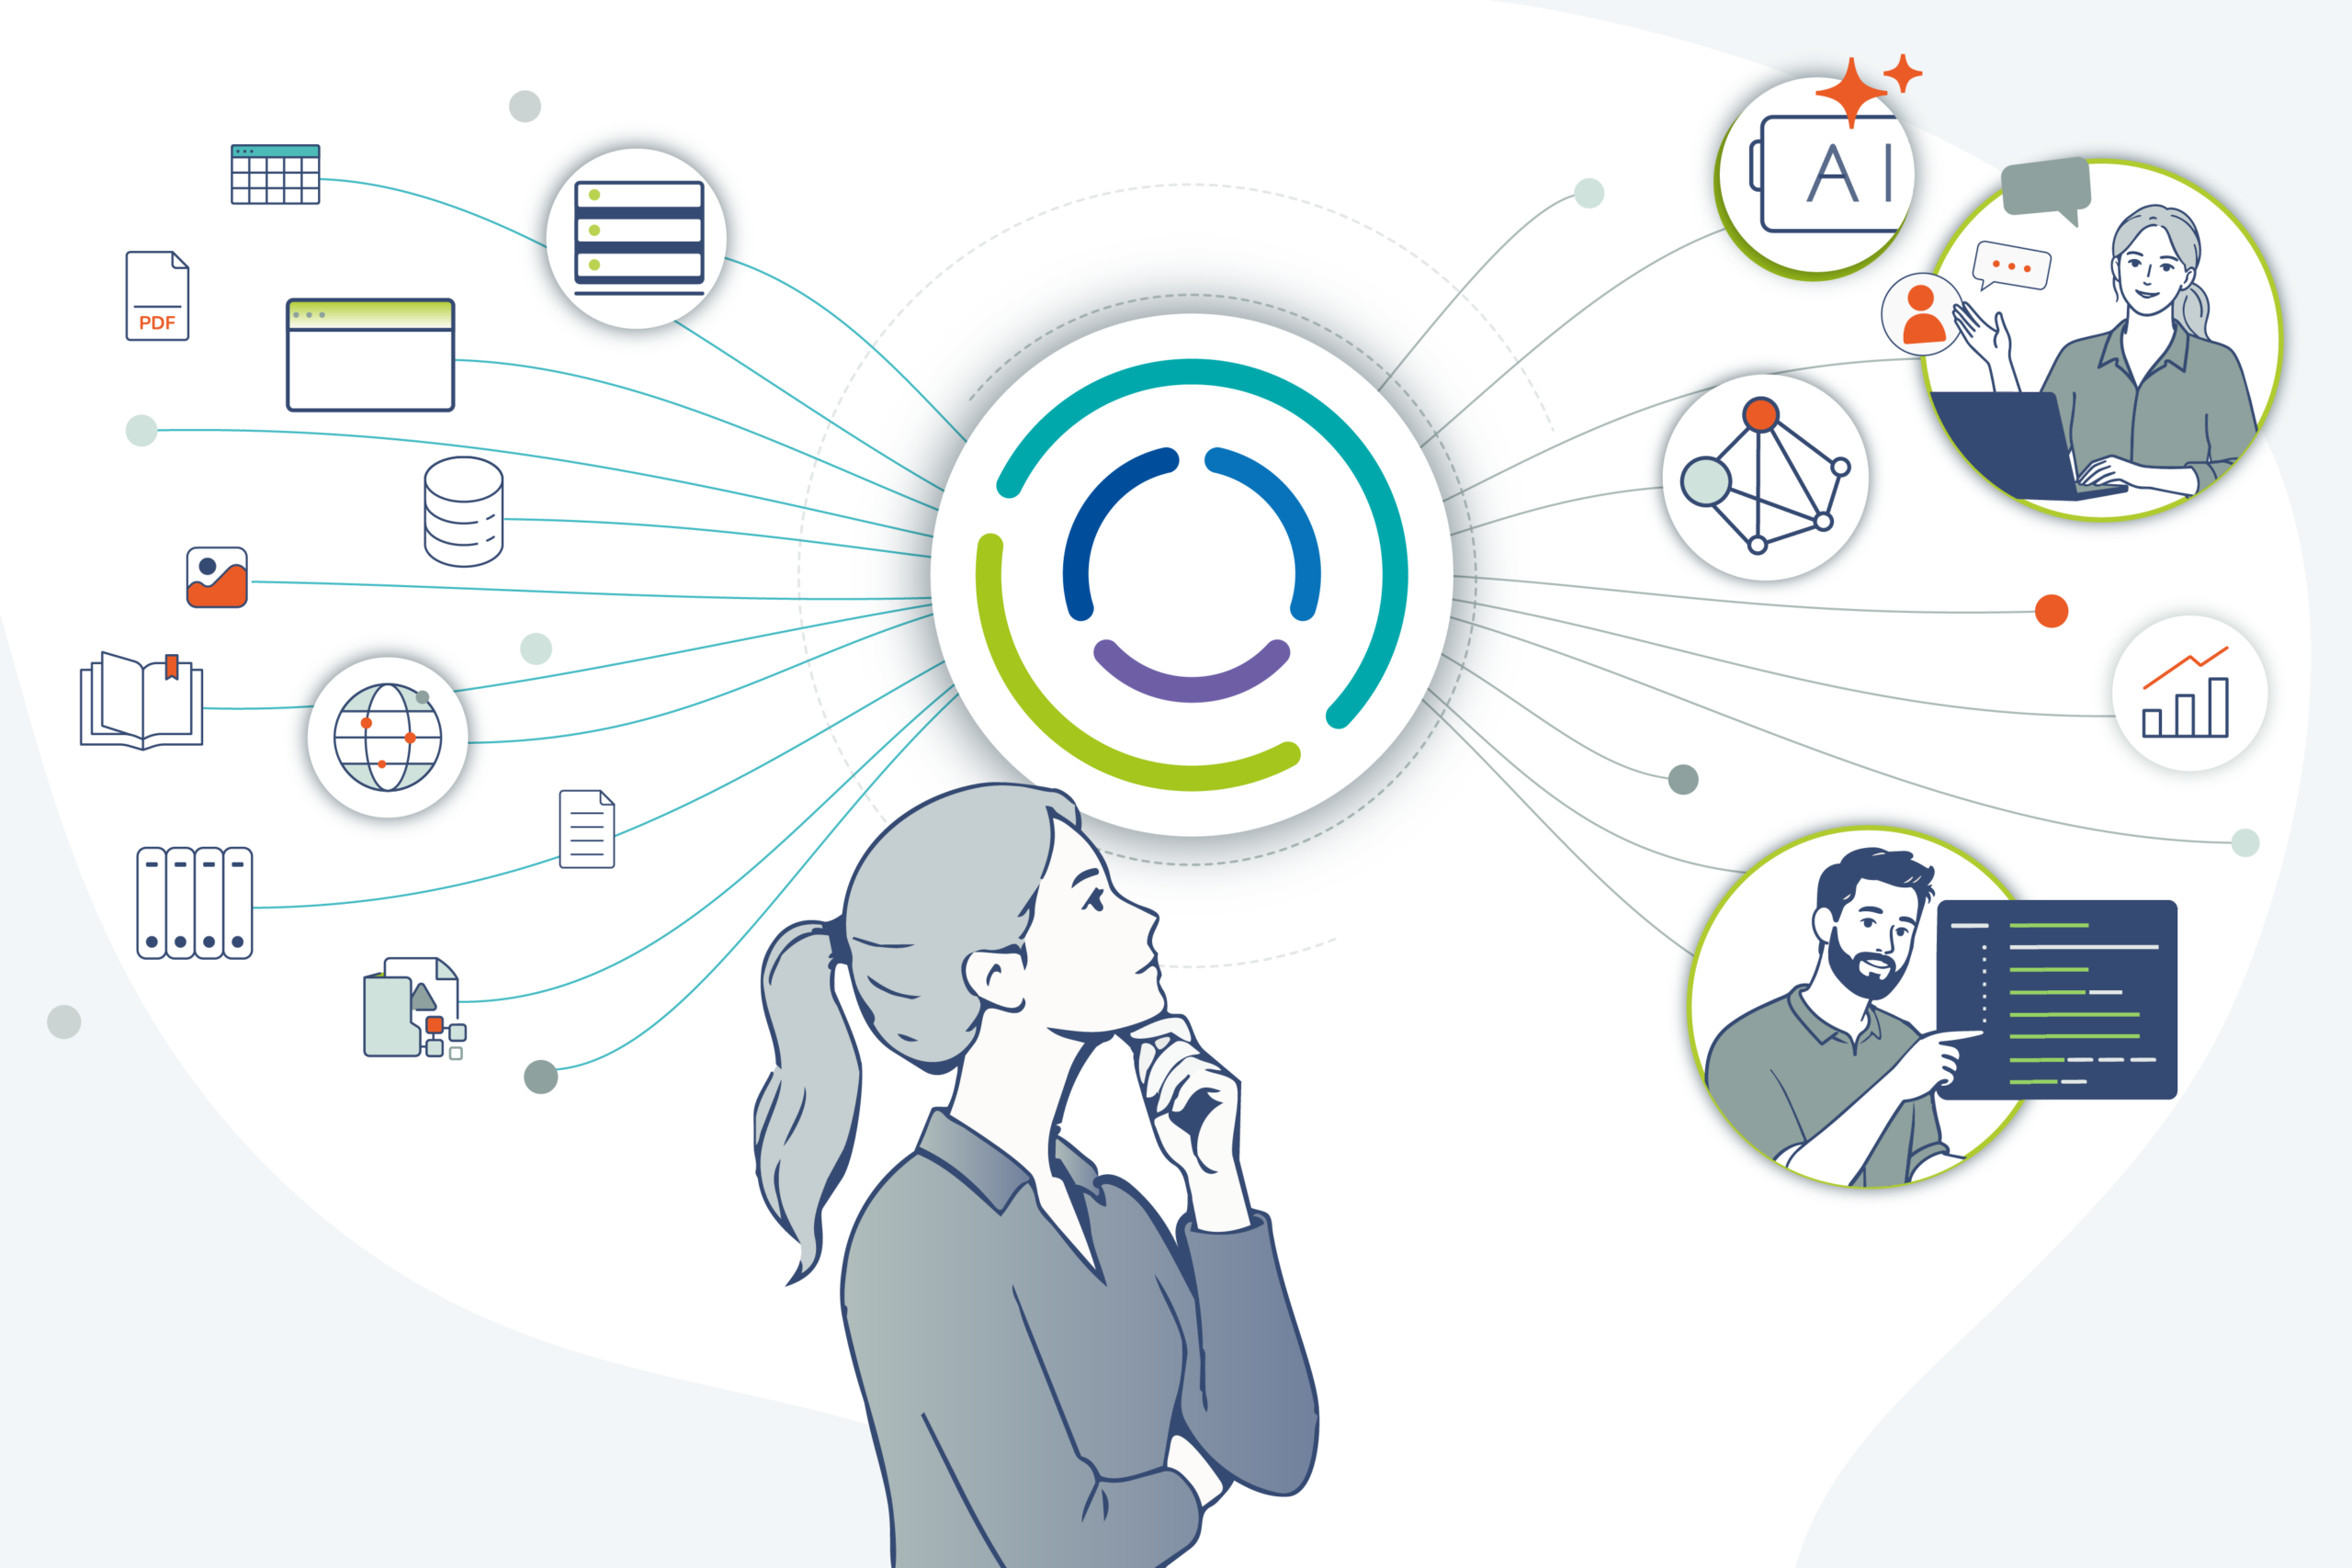
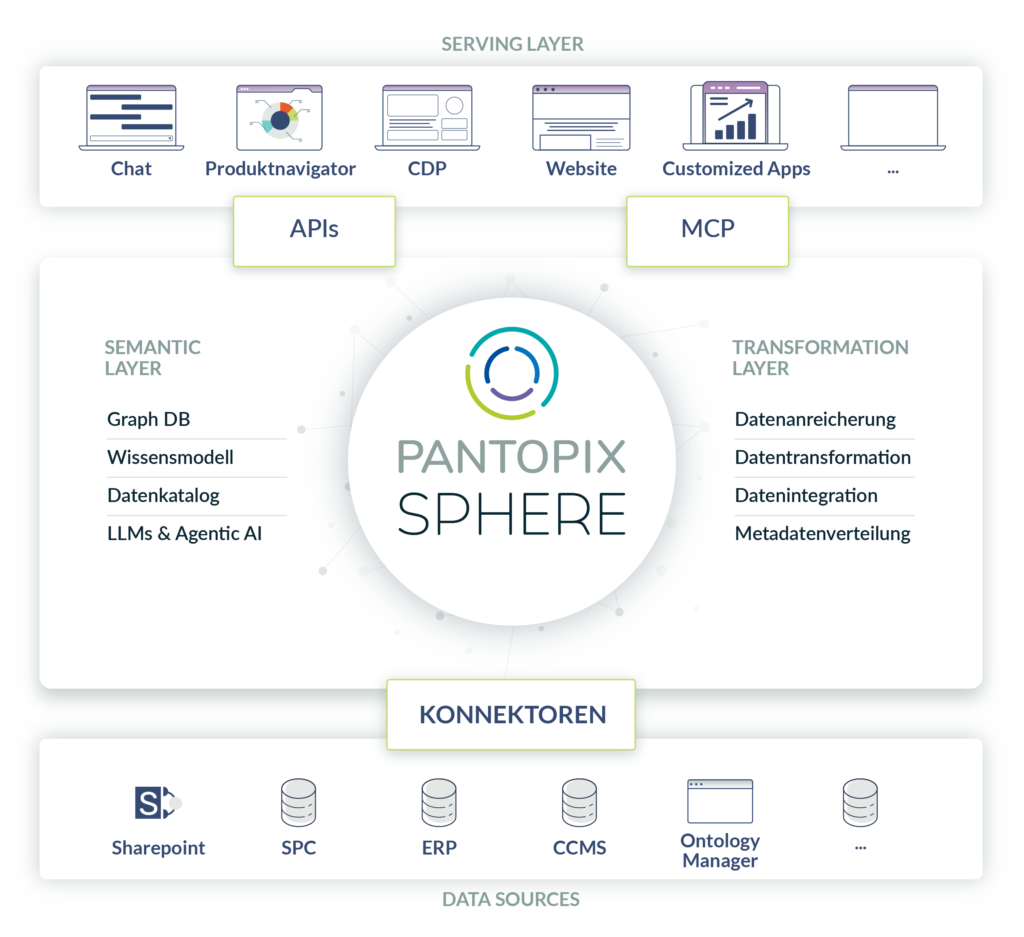
Grund dafür ist ihre Schnittstellen-Architektur, die auf etablierte Konzepte setzt. Sie unterstützt Model Context Protocol (MCP) und alle gängigen APIs. Eine Besonderheit sind die vorkonfigurierten Konnektoren, die die Wissensbasis von PANTOPIX SPHERE mit anderen Systemen verbindet. Die Plattform bringt bereits für zahlreiche Systeme solche standardisierten Schnittstellen mit, darunter Konnektoren für verschiedene Cloud Storages, NonSQL-, SQL- und Graph-Datenbanken, Ontologie-Manager, Content-Delivery-Portale und Content-Management-Systeme.
So schlägt PANTOPIX SPHERE die Brücke von diversen Datenquelle hin zu einer ebenso breiten Range an möglichen Ausgabekanälen. „Die Architektur von PANTOPIX SPHERE ist dazu so flexibel konzipiert, dass wir sehr schnell in der Lage sind, durch Erweiterungen z. B. bei den Konnektoren neue Anwendungsfälle abzudecken, die wir vorher vielleicht gar nicht im Fokus hatten.“
Unsere Lösung ist eine Plattform für die semantische Integration aller Information rund um den Lebenszyklus eines technischen Produkts. Besonders wichtig war uns, PANTOPIX SPHERE als maximal flexible Plattform zu konzipieren, die diese verschiedenen Informationswelten verbindet und daraus eine gemeinsame semantische Wissensbasis entstehen lässt.
Maximilian Gärber, Partner & Technical Consultant, PANTOPIX
So funktioniert PANTOPIX SPHERE
Die Wissensbasis im Zentrum: der Knowledge Graph
„Das Ziel ist es immer, einen semantischen Layer zu bauen“, beschreibt Max Gärber den grundlegenden Ansatz von PANTOPIX SPHERE. Die Plattform verbindet technische Produktinformationen über bestehende Systemgrenzen hinweg und führt sie in einer gemeinsamen Wissensbasis zusammen. Dabei werden Informationen nicht einfach von einem System in ein anderes übertragen, sondern in einen fachlichen Kontext gesetzt und ihre Bedeutung und ihre Beziehungen zueinander abgebildet.
Im Zentrum steht ein Knowledge Graph. Er bildet die vernetzte Wissensbasis, in der Informationen aus unterschiedlichen Quellen strukturiert zusammengeführt werden. Die Grundlage dafür bildet ein übergreifendes Datenmodell aus Ontologien und Taxonomien. Sie definieren, welche Geschäftsobjekte es gibt, wie sie zusammenhängen und welche Kategorien für sie relevant sind. „Die Ontologie ist so etwas wie ein Navigationssystem oder eine Karte“, erklärt Max Gärber. Sie bildet dabei nicht nur allgemeine Zusammenhänge ab, sondern insbesondere die individuelle Sicht eines Unternehmens auf seine Produkte, Informationen und Prozesse.
Das bedeutet allerdings nicht, dass wie von Zauberhand alles automatisch abläuft. Auch wenn PANTOPIX SPHERE per se alles mitbringt, was man dafür braucht, ist die Plattform nicht dafür vorgesehen, aus einem beliebigen Datenbestand automatisch eine Ontologie oder einen Knowledge Graph zu generieren. Das sei eines der größten Missverständnisse, die ihm mit dem Produkt begegnen, sagt Gärber. „Natürlich könnte unsere Plattform das, aber nur weil etwas theoretisch geht, muss es keine gute Idee sein. Das Ergebnis wäre eine generische Sicht auf die Dinge, also genau das Gegenteil von dem, was wir erreichen wollen. Uns geht es um die 20 Prozent, die den Unterschied ausmachen.“ Gemeint ist damit das Wissen, das ein Unternehmen individuell prägt und sich nicht einfach generisch ableiten lässt. Die unternehmensspezifischen Begriffe, Beziehungen und Prozesse müssen deshalb in einer Ontologie bewusst modelliert und mit den relevanten Informationen verknüpft werden.
Vom Quellsystem zum nutzbaren Wissen: Datenflüsse
Den Anfang des Datenflusses in PANTOPIX SPHERE bilden die bestehenden Informationsquellen eines Unternehmens. Das können strukturierte Daten aus Datenbanken und Fachsystemen, unstrukturierte Inhalte aus Dokumenten oder zentral gepflegte Metadaten, Ontologien und Taxonomien sein. „Im Prinzip geht’s um Vollständigkeit, also die vollständige Abdeckung aller Informationsarten“, erklärt Max Gärber.
Je nach Art der Informationen übernehmen unterschiedliche Komponenten von PANTOPIX SPHERE das Data Onboarding. metaSelect verteilt und synchronisiert Metadaten und Taxonomien zwischen Systemen. dataEnrich verarbeitet unstrukturierte Inhalte und kann sie beispielsweise klassifizieren, relevante Entitäten extrahieren und semantisch anreichern. dataFlow übernimmt die Integration und Transformation strukturierter Daten. „Aufgrund der Oberfläche könnte man PANTOPIX SPHERE mit einem reinen ETL-Tool verwechseln“, so Max Gärber. „Das könnte aber nicht falscher sein. Diese Funktionalitäten braucht die Plattform einfach, um Daten bewegen zu können und daraus die zentrale Wissensbasis zu schaffen.“
Um diese Wissensbasis zu erzeugen, werden die Informationen anschließend in das gemeinsame Datenmodell eingeordnet. Ontologie und Taxonomie geben den fachlichen Rahmen vor, während KI und definierte Regeln bei der Zuordnung und Verarbeitung unterstützen. Die daraus entstehenden Entitäten, Fakten und Beziehungen werden im Knowledge Graph strukturiert abgebildet. Damit werden Zusammenhänge zwischen Informationen explizit, Informationen können über Systemgrenzen hinweg semantisch konsistent verarbeitet und in ihrem jeweiligen Kontext genutzt werden.
Der Datenfluss endet jedoch nicht im Knowledge Graph. Die Wissensbasis bildet vielmehr den Ausgangspunkt für unterschiedliche Anwendungen. Informationen können für Dashboards oder andere Systeme bereitgestellt, über APIs von Maschinen und Anwendungen genutzt oder mithilfe von chatAssist im Dialog zwischen Mensch und KI erschlossen werden. „End User können vor allem technische Informationen und Sachverhalte per Chat mit dem Knowledge Graph klären“, erklärt Max Gärber. „Power User wiederum können neue Systeme anbinden und festlegen, wie Informationen in die Wissensbasis hinein- und wieder herausfließen. Maschinen können über die APIs von PANTOPIX SPHERE Datenflüsse anstoßen oder speziell aufbereitete Informationspakete abrufen.“
Die Knowledge Plattform ist also kein abgeschotteter Datenspeicher. Informationen können auch wieder in bestehende Systeme zurückfließen. „Bei unserem Kunden Vestas haben wir PANTOPIX SPHERE beispielsweise für so eine Aufgabe eingesetzt. Zehntausende Dokumente wurden analysiert, um sie mit KI zu kategorisieren und mit Metadaten auszuzeichnen. Wir haben dabei die ursprünglichen Daten nicht verändert, aber die neuen Informationen aus dem Knowledge Graphen zurückgespielt und die Quelldaten damit aktualisiert.“
Weder lassen wir Sprachmodelle isoliert auf Daten los noch stellen wir wie beim klassischer RAG-Ansatz einfach nur relevante Inhalte als zusätzlichen Kontext bereitstellt. Mit GraphRAG geben wir dem LLM Zugriff auf semantisch vernetztes Wissen, d. h. auf Informationen, ihre Bedeutung, ihre Beziehungen zueinander und den unternehmensspezifischen Kontext, in dem sie stehen.
Maximilian Gärber, Partner & Technical Consultant, PANTOPIX
Wissen kontrolliert und nachvollziehbar verfügbar machen
„Bei einer enterprise-tauglichen Wissensplattform sind für mich zwei Dinge entscheidend: Zum einen muss klar geregelt sein, wer auf welches Wissen zugreifen darf. Zum anderen muss ich jederzeit nachvollziehen können, woher Informationen kommen und was mit ihnen passiert ist“, erklärt Max Gärber zwei wichtige Governance-Anforderungen.
PANTOPIX SPHERE bildet deshalb die Organisations- und Berechtigungsstrukturen eines Unternehmens ab. Über rollenbasierte Zugriffsrechte (Role-Based Access Control, RBAC) lässt sich steuern, welche Informationen für welche Nutzer oder Nutzergruppen verfügbar sind. Schließlich sind nicht alle Informationen für jeden Mitarbeitenden, jede Abteilung oder jede Anwendung bestimmt.
Woher Informationen stammen und welchen Weg sie durch die Plattform genommen haben, ist jederzeit nachvollziehbar, weil die sogenannte Data Lineage die Herkunft und Verarbeitungskette der Daten dokumentiert. Daran lässt sich beispielsweise erkennen, aus welchem Quellsystem Informationen übernommen, wie und vom wem sie verarbeitet und wo sie anschließend wieder bereitgestellt wurden.
„Je stärker wir Wissen aus unterschiedlichen Quellen vernetzen und für Menschen, Systeme und KI verfügbar macht, desto wichtiger wird Data Governance. Deshalb ist eine solche Steuerungsebene auch fester Bestandteil von PANTOPIX SPHERE.“
Für wen ist PANTOPIX SPHERE die passende Lösung?
PANTOPIX SPHERE ist eine sehr flexible Enterprise Knowledge Plattform mit zahlreichen Use Cases rund um Produktwissen. „Aber sie ist kein Allheilmittel für jedes Unternehmen mit einem Datenproblem“, sagt Max Gärber. „Es gibt natürlich einen gewissen Aufwand für die Erstellung und Abstimmung der Konzepte und Zusammenhänge, die modelliert werden sollen. Ich denke, man muss eher fragen, wo der Einsatz von PANTOPIX SPHERE sinnvoll ist.“ Und das ist er dort, wo Unternehmen mit komplexen oder stark konfigurierbaren Produkten arbeiten und dauerhaftes Wissen über Produkte, Strukturen und Zusammenhänge nutzbar machen wollen.
Die Plattform ist darum besonders stark auf das produzierende Gewerbe und die Industrie ausgerichtet. Dazu gehören Branchen wie Maschinen- und Anlagenbau, Medizintechnik sowie Luft- und Raumfahrt. Weniger im Fokus stehen sehr einfache Produktwelten oder Daten, die sich permanent verändern, etwa Bewegungs-, Logistik- oder Sensordaten. „Unser Ziel ist keine Plattform für möglichst viele Datenbewegungen in Echtzeit, sondern eine belastbare Wissensbasis für langfristig relevante Produktinformationen“, fasst Max Gärber zusammen. „Dass ein Unternehmen seine Geschäftsobjekte, Prozesse und relevanten Zusammenhänge beschreiben kann, gehört aber auch zu den Voraussetzungen, um PANTOPIX SPHERE einzusetzen.“
Ausblick: Die Zukunft von PANTOPIX SPHERE
Vor der ursprünglichen Vision ist die heute einsetzbare Knowledge Plattform PANTOPIX SPHERE kaum zu unterscheiden. Lediglich ein Teil der Entwicklung steht aus und dieser ist ebenso ambitioniert, wie der Rest des Produkts. „Im Moment werden die Flows, also die Datenflüsse, über ein normale Benutzeroberfläche konfiguriert. Was noch fehlt, ist die Möglichkeit, das über natürliche Sprache zu tun. Wenn jemand den Flow beschreiben kann, dann sollte PANTOPIX SPHERE das ausführen können“, beschreibt Max Gärber die noch fehlende Komponente. Diese Entwicklung besitzt so viel Innovationskraft, dass PANTOPIX die Forschungszulage von Bundesministerium für Forschung, Technologie und Raumfahrt erhalten hat.
Erleben Sie, wie PANTOPIX SPHERE Ihre Informationen in nutzbares Wissen verwandelt.
Die Evolution von PANTOPIX SPHERE
Schon lange vor dem Produkt beschäftigte PANTOPIX die gleiche Herausforderung: unterschiedliche Systeme und nicht zusammenpassende Datenstrukturen miteinander zu verbinden. Dieses Integrationsproblem bildet den Ausgangspunkt der Plattform.
2015–2018
Metadaten über Systemgrenzen hinweg nutzbar machen
Die früheste Entwicklungsstufe war ein Tool, das später zur App metaSelect werden soll. In einem Projekt bei ZEISS wurden zentral gepflegte Taxonomien und Metadaten gezielt an Technische Redaktion und Content-Delivery-Systeme verteilt. Damit ließ sich Content aus unterschiedlichen Systemen über gemeinsame Metadaten wieder miteinander in Beziehung setzen.
Datenintegration und Migration
Aus den Projekten wurde deutlich, dass kaum eine umfassendere Informationslösung ohne Datenmigration, Transformation und Integration auskommt. Daraus entwickelte sich dataFlow als weiterer Baustein der späteren Plattform.
Ab 2022
LLMs werden zum Aha-Moment
Mit der neuen Leistungsfähigkeit von Large Language Models änderten sich die Möglichkeiten grundlegend. Unstrukturierte Dokumente konnten plötzlich mit vertretbarem Aufwand verarbeitet, klassifiziert und erschlossen werden. Daraus entstanden dataEnrich und chatAssist. Damit war das Konzept von PANTOPIX SPHERE im Wesentlichen komplett: regelbasierte und semantische Verarbeitung konnte mit den Stärken von LLMs kombiniert werden.
2023
Aus Komponenten wird eine Plattform
Der entscheidende Schritt zur heutigen Knowledge Plattform kam mit dem Knowledge Graph als zentralem Baustein. „Ab da war klar, dass wir nicht nur einzelne Tools haben, die irgendwas machen, sondern ein System, das etwas speichert und sich verändert, wächst“, beschreibt Max Gärber diesen Entwicklungsschritt.
Heute
Flexible Datenintegration trifft Semantic AI
Heute verbindet PANTOPIX SPHERE die verschiedenen Entwicklungsstränge in einer Plattform: heterogene Informationsquellen integrieren und transformieren, Informationen semantisch strukturieren, in einem Knowledge Graph miteinander vernetzen und diese Wissensbasis für Menschen, Systeme und KI nutzbar machen. Der Knowledge Graph ist dabei fester Bestandteil der langfristigen Vision von PANTOPIX SPHERE.
Zukunft
PANTOPIX SPHERE per Sprache konfigurieren
Die ursprüngliche Vision ist weitgehend umgesetzt. Ein noch ausstehender Entwicklungsschritt ist die stärkere sprachbasierte Interaktion mit der Plattform: Nutzer sollen künftig einen gewünschten Datenfluss (Flow) beschreiben können, den die Plattform anschließend umsetzt.
Sandy Hedig
Marketing Manager | PANTOPIX
Maximilian Gärber
Technical Consultant | PANTOPIX
Wir informieren Sie gerne regelmäßig über neue Artikel, Videos oder Podcast-Folgen.

Knowledge
Erfahren Sie mehr über das Vernetzen von Informationen